一、MiniMax H3 是什么?
MiniMax 于 2026 年 8 月 3 日正式开源 H3——这是一个通用全模态生成系统,不是单纯的”文生视频”模型。它能够统一理解由文本、图像、视频、音频构成的多模态上下文,并直接生成带原生立体声音频的视频。
核心能力一览
| 能力 | 参数 |
|---|---|
| 输出时长 | 4 ~ 15 秒 |
| 最高分辨率 | 2K |
| 音频生成 | 与画面同步生成,32kHz 立体声(非后期配音) |
| 语言支持 | 中、英、日、韩、法等 11 种语言的口型与语音 |
| 榜单成绩 | Artificial Analysis:视频编辑全球第一,文生视频第二,图生视频第三 |
它基于全新的 H3-Context-IR 架构,与上一代 Hailuo 01 / 02 完全不同。此外,全能版(无限制版)模型也已在社区发布,相比官方版几乎没有内容限制,创意发挥空间更大。
效果示例(示意图)
二、显存到底要多少?(先看这段,再决定下载哪个模型)
网上普遍流传”8G 显存也能跑”,这句话没错,但有条件。以下是目前公开实测数据的整理:
| 配置 | 显存 | 系统内存 | 实测表现 |
|---|---|---|---|
| 稳定跑通配置 | 12G | 32G + NVMe 固态 | 5 秒 480p / 20 步 ≈ 5 分钟 |
| 官方未量化版验证 | 32G×2(共 64G) | 约 384G | 5 秒 1344×768 / 50 步 ≈ 9.3 分钟 |
为什么 12G 显存能跑 40 多 G 的模型? 因为 ComfyUI 采用按层动态调度(offload):需要哪一层就把哪一层搬进显存,其余留在内存和硬盘。显存不够不会直接报错,只是变慢。
8G 能不能跑? 能,但要靠更激进的量化(Q2、Q3)+ 大量 offload,出片时间会明显拉长,而且低量化对画质有实打实的损伤。如果你是 8G 显卡,建议:
- 系统内存 32G 起步
- 硬盘必须是 NVMe 固态(机械硬盘 offload 慢十倍)
- 从 480p / 20 步 / 5 秒 开始试,不要一上来就冲 720p
量化版本怎么选(关键)
| 显存 | 推荐量化 |
|---|---|
| 24G 及以上 | Q8 或官方 INT8 / NVFP4 |
| 16G | Q5 或 Q4 |
| 12G | Q4 |
| 8G | Q3,或混合精度 Q2 |
三、部署完整教程(五步走)
准备:升级 ComfyUI
H3 需要 ComfyUI 0.27 或更高版本,老版本没有对应的原生节点,这一步跳过后面全是坑。
- 官方下载:ComfyUI 官网(见文末资源区)
- 备用整合包:含全能版工作流及节点(见文末资源区)
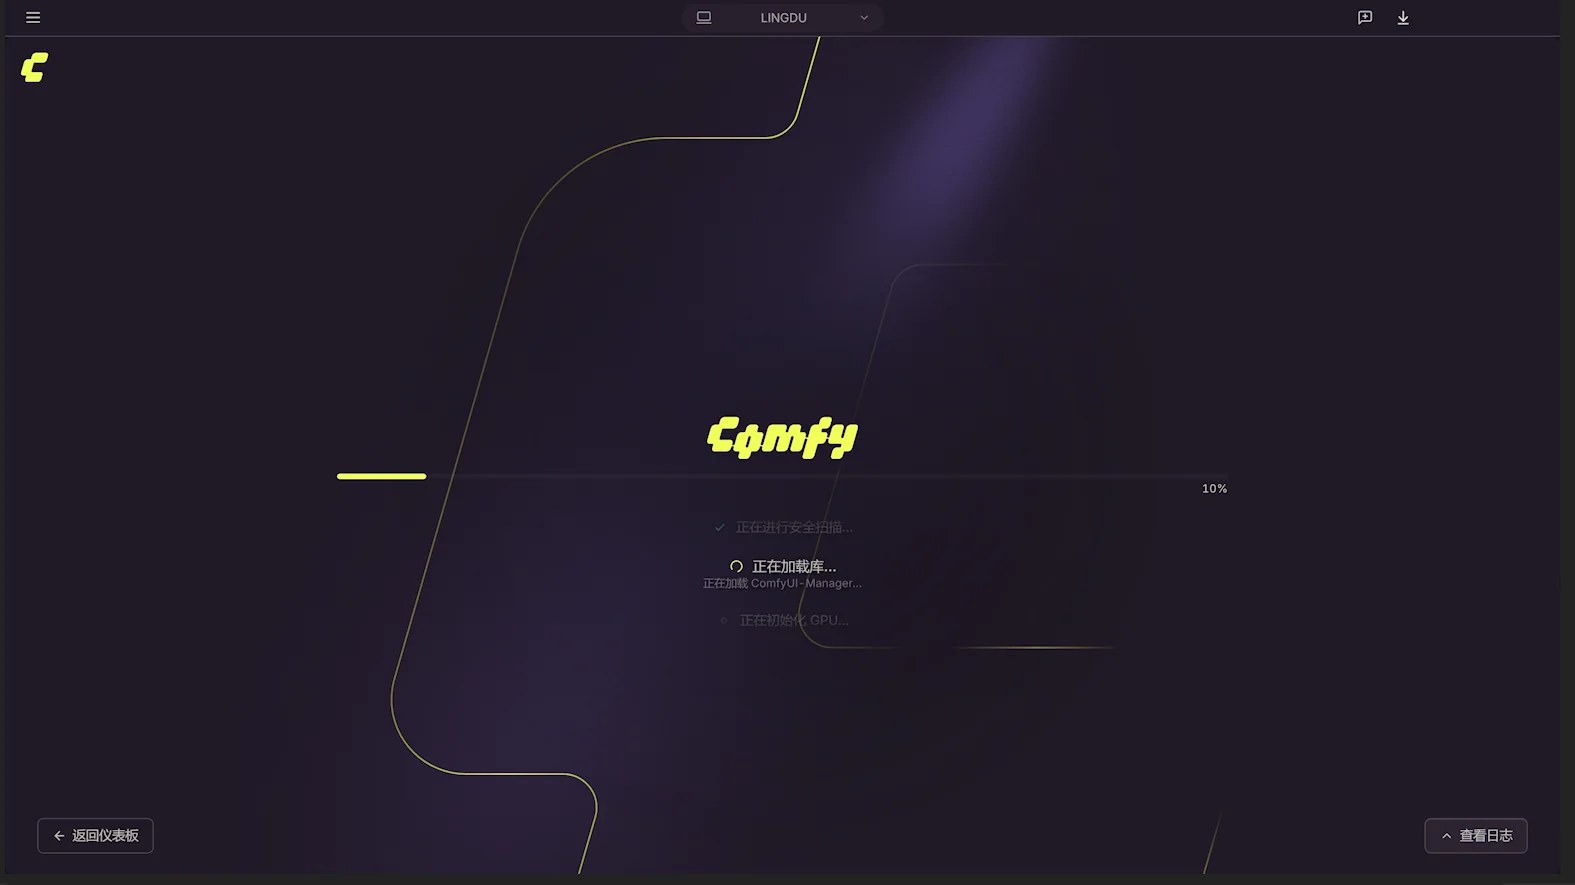
如果你之前装过 ComfyUI 桌面版,务必升级到最新版;用整合包的,直接用启动器里的”更新”功能。更新完启动一次,在右下角确认版本号。
第一步:下载安装 ComfyUI
- 打开 ComfyUI 官网/下载入口,下载对应系统的客户端
- 双击安装包,一路”下一步”,保持默认设置装完
- 打开 ComfyUI,界面左侧有”模板”入口——后面下模型、导工作流都从这里进
第二步:选择并下载官方模型
在 ComfyUI 的模型下载中心 / 模板中心,有 3 种 MiniMax H3 开源模型:
- 文生视频
- 图生视频
- 视频转视频
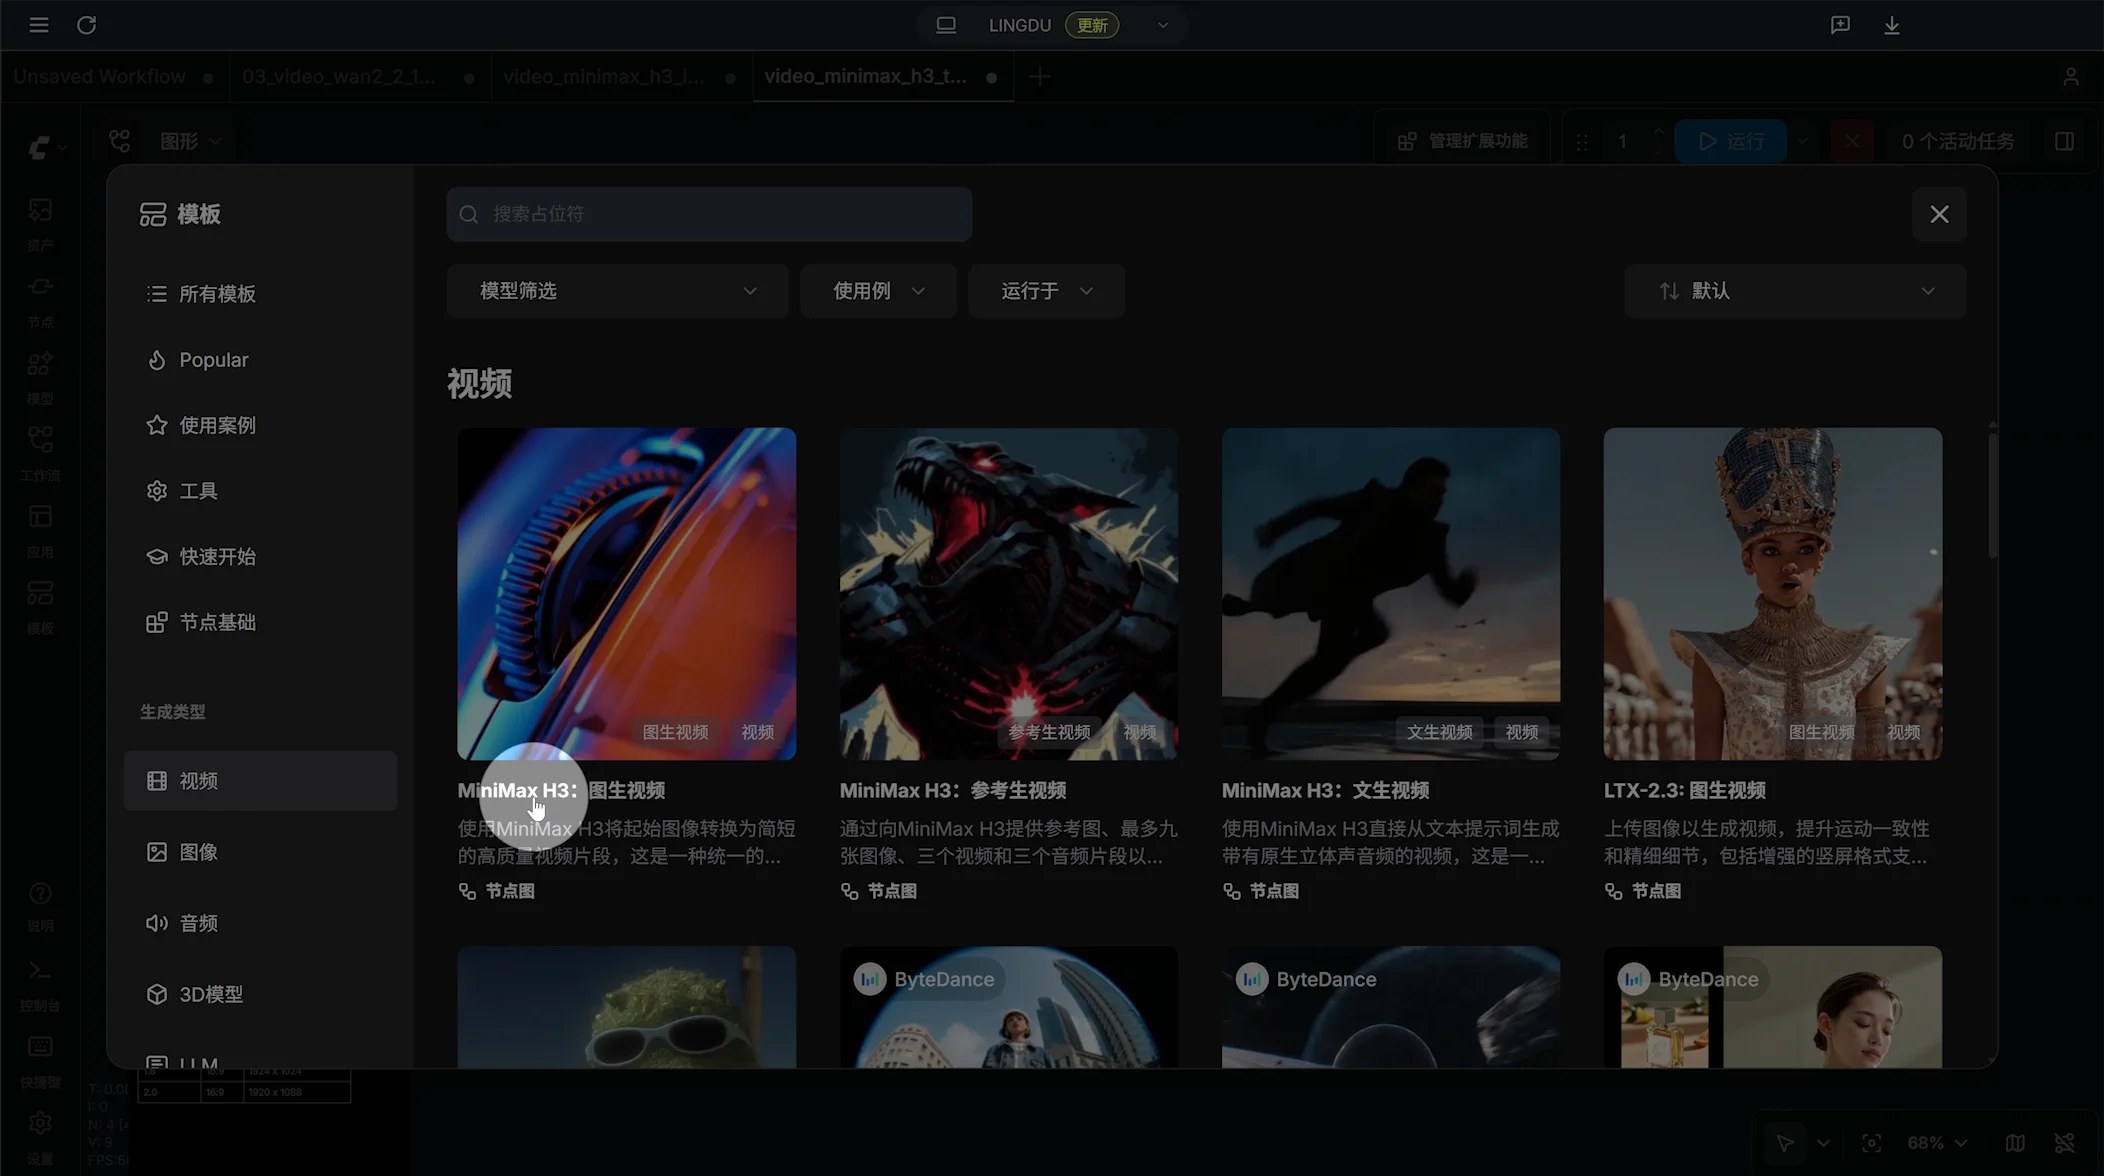
按需下载。生成分辨率建议设小一点(如 480p),可以大幅提升生成速度;生成完成后,再用高清放大工具提升到 1080p / 2K / 4K(工具见文末资源区)。
第三步:下载全能版(无限制)模型
想要更自由的创意空间,可以下载全能版模型。它有 3 个文件:
| 文件 | 体积 | 说明 |
|---|---|---|
| BF16 满血版 | 约 47.97G | 画质最高,显存要求高 |
| 量化版 | 约 24.55G | 家用消费级推荐,效果也不错 |
| NVFP4 量化版 | 较小 | 8G 显存专用 |
完整文件列表(HuggingFace 上的 4 个文件):
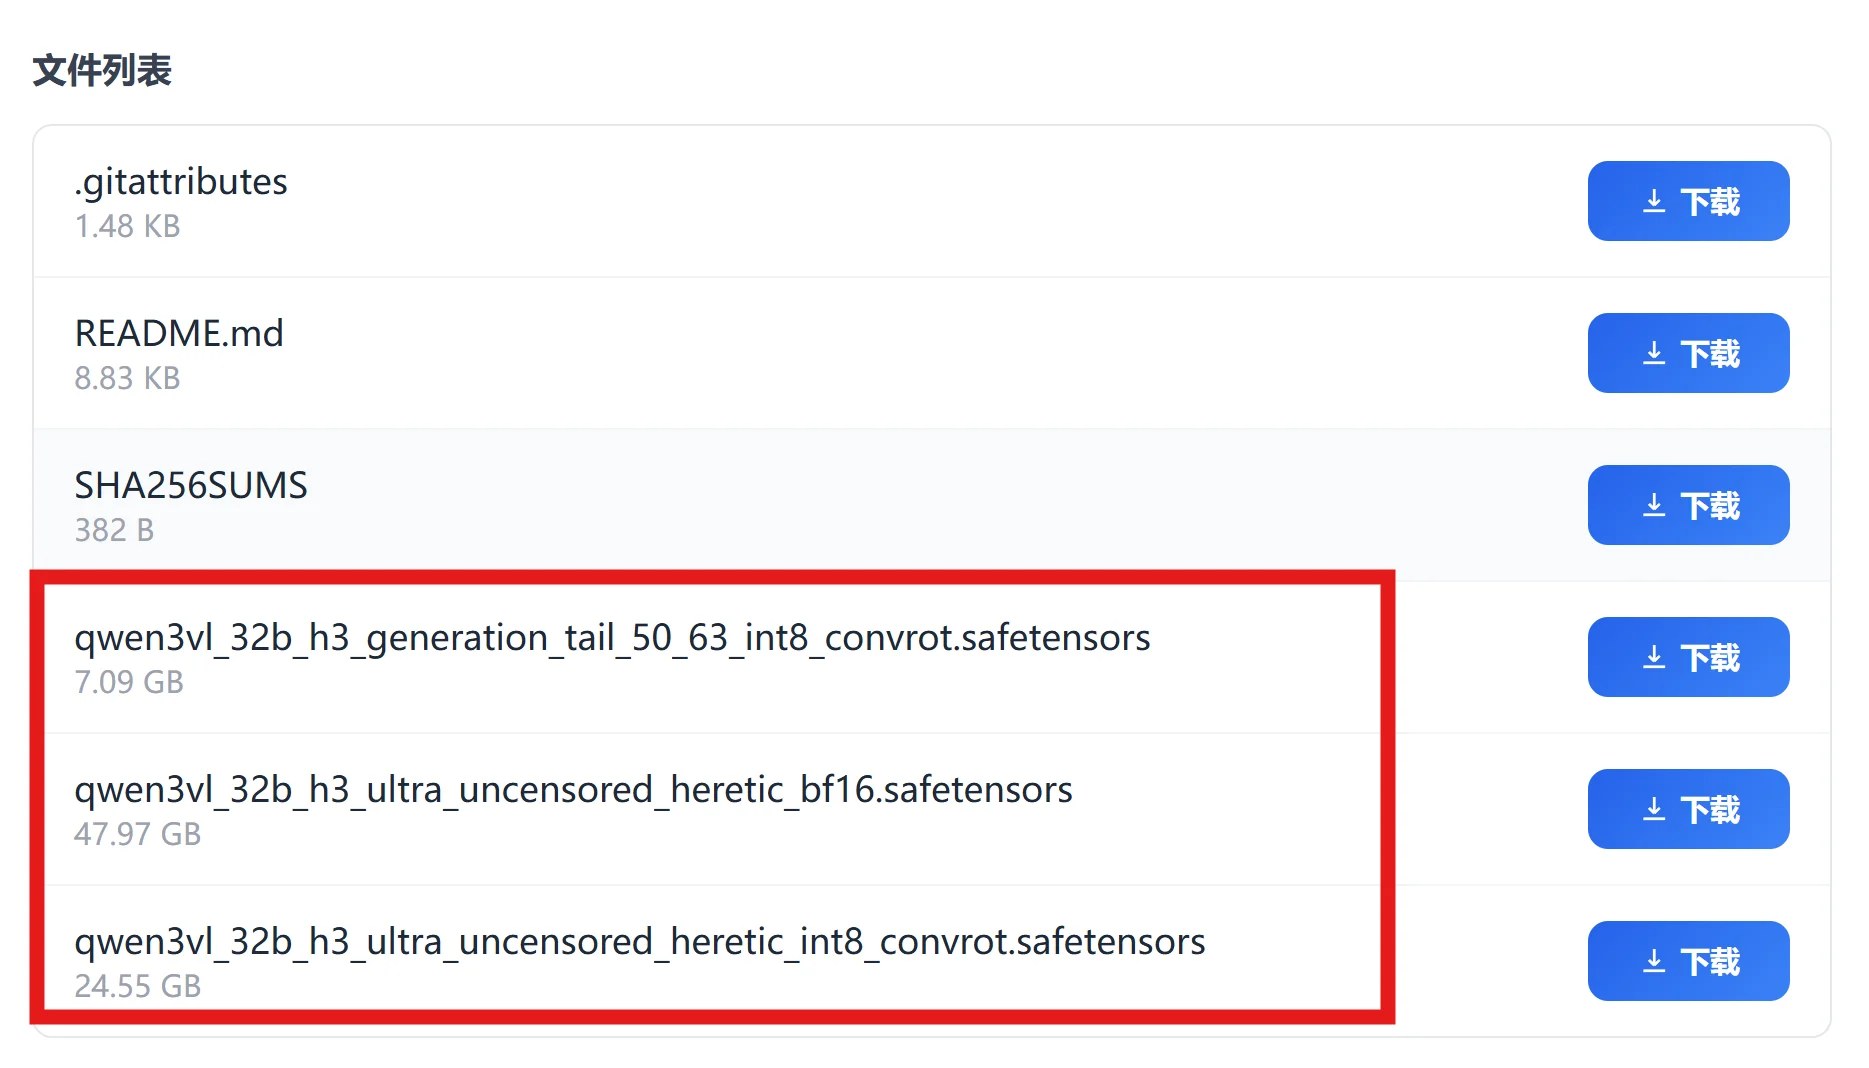
下载渠道:HuggingFace / 整合包 / 网盘(见文末资源区)
第四步:安装工作流节点 + 加载工作流
- 下载 ComfyUI-MiniMax-H3-Guide 工作流节点(GitHub,见资源区),放进 ComfyUI 的
custom_nodes/目录 - 重启 ComfyUI
- 下载工作流 JSON 文件(GGUF 仓库一般自带,类似
MiniMax FL2V GGUF (WORKFLOW).json),直接拖进 ComfyUI 界面即可加载
加载后检查这几个节点:
| 节点 | 选择 |
|---|---|
| Unet Loader (GGUF) | 选你下载的主模型 |
| CLIP Loader (GGUF) | 选 qwen3vl 文本编码器 |
| VAE Loader | 两个:视频 VAE 和音频 VAE,别接反 |
| 分辨率和帧数 | 第一次跑先设 480p、5 秒 |
节点全部变绿、没有报红,就可以点生成了。
第五步:文件放置目录(必须放对)
模型文件必须放在正确位置,否则加载报错:
| 文件 | 放置目录 |
|---|---|
| 主模型(如 MiniMax-H3-FL2VA-Q4_K_M.gguf) | models/unet/ |
| 文本编码器(qwen3vl_32b_minimax_h3_Q4_K_M.gguf) | models/text_encoders/ |
| 视频 VAE(minimax_h3_video_vae_fp16.safetensors) | models/vae/ |
| 音频 VAE(必须 fp32:minimax_h3_audio_vae_fp32.safetensors) | models/vae/ |
⚠️ 注意:音频 VAE 必须是 fp32 版本!用 fp16 会出现音画不同步或者干脆没声音(亲身踩过的坑)。
另外:如果走官方原生路线,模型权重需要同时放在
models/MiniMax-H3/(单文件权重)和models/diffusers/MiniMax-H3/(分片版本,含 config.json)两个目录,缺一个都会报错。
第六步:第一次生成
- 上传一张图(图生视频)或输入提示词(文生视频)
- 分辨率设 480p、时长 5 秒、步数 20 步
- 点运行
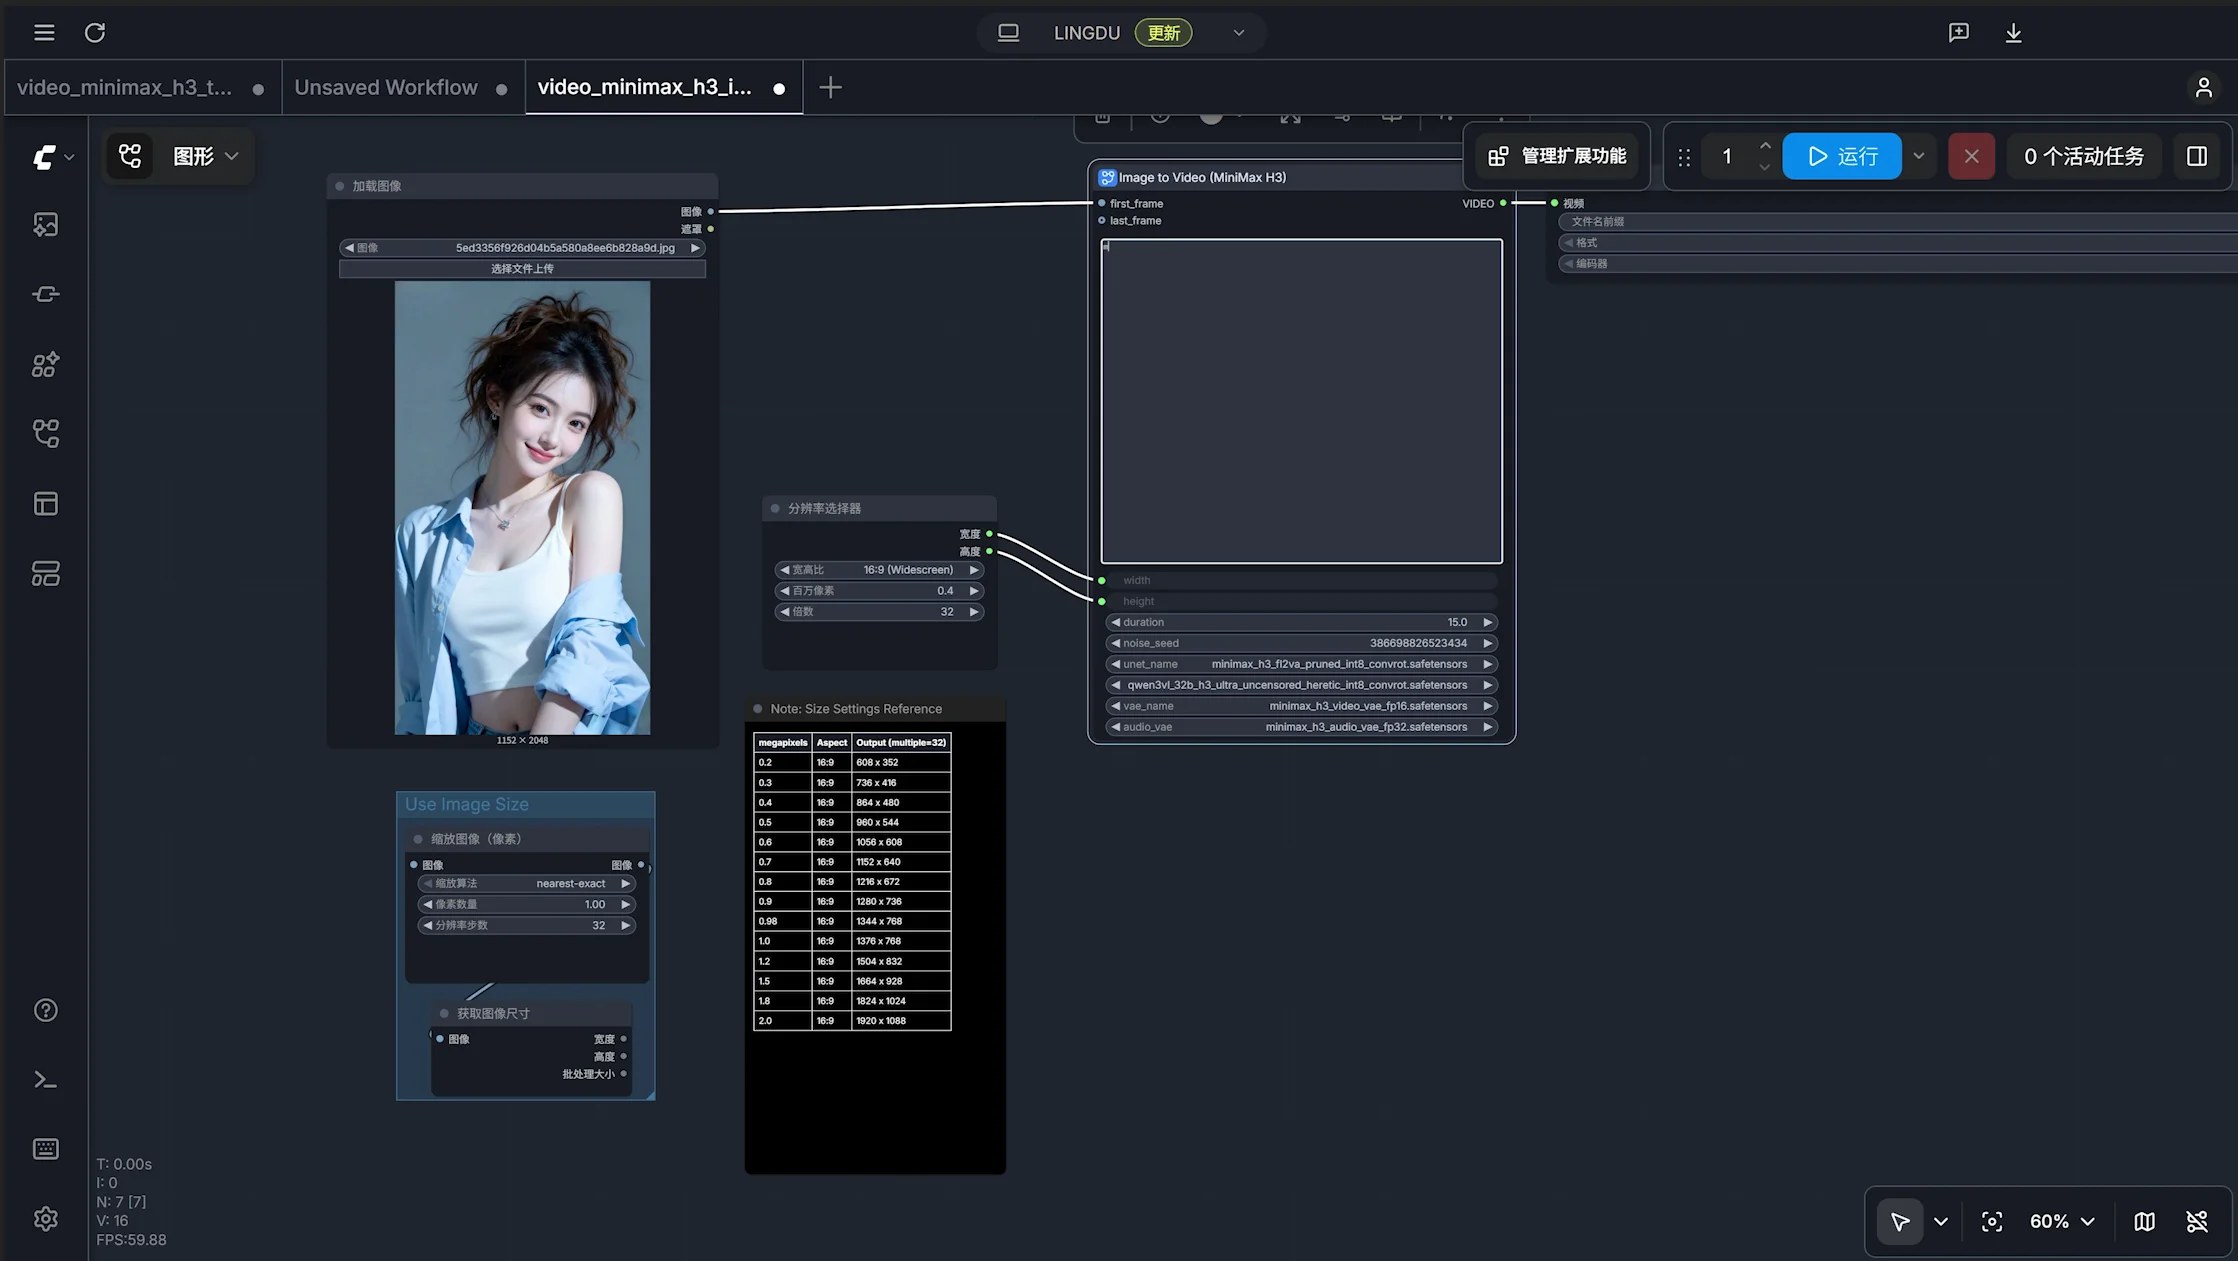
第一次会非常慢——因为要把权重从硬盘加载进来。8G~12G 显存的机器,5 秒 480p / 20 步,做好等 8~15 分钟的心理准备。第二次开始会快很多(部分权重已缓存到内存)。
四、提示词进阶指南(决定出片质量的关键)
跑通只是开始,真正决定出片质量的是提示词。H3 能听懂镜头语言,写法和以前不同。
1. 写”分镜”,不要写”标签”
以前 SD 那套关键词堆砌在 H3 上效果一般。H3 更吃完整的场景描述 + 镜头调度:
❌ 不好的写法:
一个女人,咖啡馆,下雨,电影感,8k,高质量
✅ 好的写法:
黄昏的咖啡馆靠窗位置,窗外下着小雨。一位穿米色针织衫的女性正低头搅拌咖啡,镜头从她的手部特写缓慢上摇至面部,她抬头看向窗外,嘴角微微上扬。暖色调室内灯光,窗外冷色调环境光形成对比。背景音:雨声、咖啡杯轻碰声、隐约的爵士乐。
区别在于:第二种把画面、动作、镜头运动、光线、声音全部交代清楚了。H3 的音频跟画面一起生成——你不写声音,它就自己猜,猜出来的十有八九不是你要的。
2. H3 生成的”分镜”画面示例
3. 镜头运动直接用术语
推、拉、摇、移、跟、升降,这些术语 H3 都认。也可以写英文:
dolly in(推近)pan left(左摇)crane shot(升降镜头)handheld(手持)
想要稳定的运镜就写明白,别指望它读心。
4. 角色一致性靠 Ref2VA
这是 H3 最实用的功能:用 Ref2VA 分区,喂进去同一个角色的多张参考图(最多 9 张,建议 3~5 张不同角度),再配一段语音参考,就能做出跨镜头同一个人、同一个声音的连续片段。
做口播、系列内容、虚拟主播,这个功能直接砍掉一大半工作量。
经验:参考图的质量比数量重要。5 张清晰的正侧面照,效果远好过 9 张糊图。
5. 15 秒不够用怎么办
单次最长 15 秒是硬限制。想做长片,用尾帧接首帧的方式串联:
- 第一段的最后一帧导出
- 作为第二段的首帧输入
- 配合 Ref2VA 锁角色
就能做出连贯的多镜头。社区已经有人做出 30 秒三镜头、人物和声音全程一致的片子。
五、常见问题排查表
| 问题 | 原因 | 解决 |
|---|---|---|
| 报错找不到节点 | ComfyUI 版本太老 / 没装 GGUF | 升级 ComfyUI 0.27+,安装 ComfyUI-GGUF |
| 加载模型爆显存崩溃 | 量化版本太高 | 换更低量化,启动参数加 --lowvram |
| 生成出来没有声音 | 音频 VAE 用了 fp16 | 换回 fp32 版本 |
| 画面有了但音画不同步 | 视频/音频 VAE 接反 | 回到工作流检查 VAE 连线 |
| 速度慢到无法接受 | 模型在机械硬盘 / 内存不足 | 换 NVMe 固态;加大系统内存 |
| 画面崩坏、人物变形 | 量化太狠(Q2/Q3) | 加显存或降分辨率换质量 |
六、资源清单
| 资源 | 说明 | 获取 |
|---|---|---|
| ComfyUI 客户端 | 免费开源,0.27+ 版本 | comfy.org |
| ComfyUI 整合包(备用) | 含全能版工作流及节点 | 夸克网盘 |
| MiniMax H3 模型 | 文生/图生/视频转视频 | 模型中心 / 网盘 |
| 全能版模型(BF16/量化) | BF16 47.97G / 量化 24.55G | HuggingFace / 夸克网盘 / 整合包 |
| NVFP4 量化版 | 8G 显存专用 | HuggingFace / 整合包 |
| 工作流节点 | ComfyUI-MiniMax-H3-Guide | GitHub / 夸克网盘 |
| 工作流 JSON | 直接拖入 ComfyUI 界面 | 夸克网盘 / 备用 |
| 示例提示词 | 文生/图生各 1-2 条 | 见上文”提示词进阶指南” |
| 视频高清放大工具 | 升 1080p/2K/4K | 夸克网盘 / 备用 |
💡 部分资源还有备用渠道(如 cloudeop 网盘),链接失效可留言获取。
结语
H3 这次开源的意义,不只在于”又多了一个能跑的模型”,而在于开源视频模型第一次在可控性上追平了闭源产品——音画同步生成、角色跨镜头一致、镜头语言可控、11 种语言口型,这些能力半年前还是闭源产品的护城河,现在权重就在你的硬盘里。
配置门槛确实还在:12G 显存是目前比较舒服的起点,8G 能跑但需要耐心。考虑到这才是开源第一周,量化方案和推理优化的迭代速度一向很快,一两个月后大概率会更友好。
想玩的朋友现在就动手吧。部署中遇到问题,欢迎评论区留言,我看到都会回。
内容整理自开源社区公开资料与实测经验,界面截图来源于公开教程。